AI Agent 时代,我如何和 AI 共建电子商务法知识库
从一门电子商务法课程出发,把每一次提问、核验和判断写回 Obsidian,让知识库持续长成课件、案例与合规工具。
- 更新于
- 核验于
- Evidence
- personal-observation
- 法律 AI
- 电子商务法
- Obsidian
- 知识管理
在 AI Agent 时代,我学一个新领域时,不会先让 AI 给我一份“入门介绍”。
我的第一个习惯是:先和 AI 一起,在 Obsidian 里搭一个属于自己的知识库。
一条答案很快会被忘记,但共同建起来的知识结构,会随着每一次提问继续生长。对我来说,真正有价值的不是“这次问到了什么”,而是这次查到的资料、形成的判断和发现的新问题,能不能成为下一次工作的起点。
从“向 AI 要答案”变成“和 AI 搭系统”
我很认同 Andrej Karpathy 对 LLM Knowledge Bases 的比喻:Markdown 编辑器像开发环境,LLM 像程序员,Wiki 像代码库。
人不必亲手维护每一条链接,但要提出需求、提供材料、判断质量;AI 则可以持续阅读、摘要、分类、交叉引用和维护。这样一来,知识不只是被保存,而是形成可以反复调用的关联路径。
这也是我理解的个人知识管理系统(PKMS):它不是一个越来越大的收藏夹,而是一套会参与思考和工作的基础设施。
我不是把 AI 当作一次性问答框,而是把它当作共同维护知识结构的协作者。
第一次认真实践:从一门电子商务法课程开始
我第一次完整实践这套方法,是在准备《电子商务法》课程时。
电子商务法并不是把法条按章节放进文件夹就够了。真正遇到平台治理、直播营销、消费者权益、数据合规或保证金争议时,需要同时看规则依据、交易结构、裁判分歧、证据链和业务动作。因此,我和 AI 一起把知识库逐步搭成了几个相互连接的层次:
法规层
法规原文、效力状态、配套规定与核验时间。
案例层
事实、争点、裁判观点、证据要点与合规启示。
专题层
平台责任、直播带货、消费者保护、数据合规等专题地图。
教学层
章节框架、教案、案例挂接表和课堂讨论问题。
应用层
风险清单、审查流程、合规 SOP 与工作底稿。
产出层
课件、研究小结、案例分析,以及能够继续迭代的专业产品。
这几个层次不是彼此隔离的文件夹。一个平台责任专题会链接到具体法条、监管文件和裁判案例;一张案例卡又会被课件、风险清单和审查流程继续调用。每次使用都可能暴露新的缺口,再反向推动资料补充。
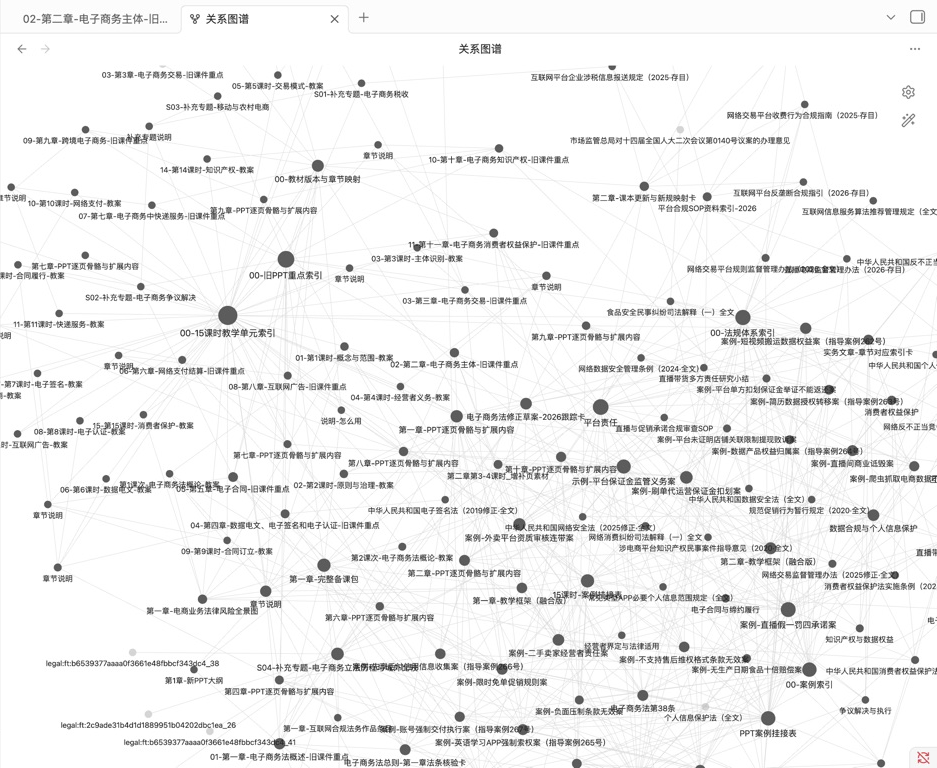
当前知识库的关系图谱:法规、案例、章节、专题与工具通过双向链接逐渐形成网络。画面仅保留公开安全的知识节点,不展示本地路径或私人资料。
我是怎样从 0 到 1搭起来的
1. 先确定要解决的真实问题
我不会从“收集所有电子商务法资料”开始,而是先设定一个能完成的项目:例如梳理平台保证金的合规边界、设计直播促销上线前审查流程,或者研究个人信息授权应该怎样落到产品页面。
项目会迫使我判断:我缺的是法条、案例、业务规则,还是证据与流程。
2. 把可靠原始资料放在最底层
我优先保存能够回到原文核验的材料,包括现行法规、司法解释、监管文件、完整裁判文书和公开的平台规则。AI 的摘要必须指向来源,不能取代来源。
3. 用固定模板拆成可复用的卡片
我和 AI 一起设计法条卡、案例卡、专题卡、课程卡和合规工具模板。模板的意义不是把笔记做得整齐,而是逼迫自己回答同一组关键问题:依据是什么、适用条件是什么、事实如何对应、证据在哪里、对业务动作有什么影响。
4. 建立法条、案例与业务之间的双向链接
当某个案例涉及平台扣划保证金,它不会只停留在“案例”文件夹里,而会被链接到平台责任、格式条款、举证责任、资金处置和后台留痕等专题。知识库开始从目录变成一张可导航的判断网络。
5. 在 Obsidian 里直接让 Agent 参与工作
我会通过 Claudian 等 Agent 工具,让 AI 读取当前笔记和已链接的材料,再继续追问。比如我问:“平台能不能扣保证金?”
它不应只给一个泛泛答案,而要把平台规则、相关法条和不同裁判结果放在一起,继续追问:平台在什么情况下有依据?举证责任由谁承担?业务端应当保留哪些记录?后台系统需要设置哪些强制字段?
这时,我不是在向 AI 索取一个结论,而是在和 AI 一起完善一套可以反复调用的专业判断系统。
6. 把阶段性判断和最终产出写回知识库
课件、案例分析、审查清单或合规 SOP 不是知识库的终点。每次产出都会检验原来的结构是否够用,并把新的判断、例外和待核验问题重新写回去。
下一个问题,不再从空白对话框开始。
我和 AI 的分工
我负责: 寻找可靠资料、提出真实问题、判断什么值得留下,并为最终结论负责。
AI 负责: 阅读、摘要、分类、建立关联、发现缺口,以及承担重复性的维护工作。
这种分工让我更清楚地意识到:Agent capabilities 改变的并不是“AI 能不能再回答得长一点”,而是它能否长期参与一个知识系统的维护。过去最难的工作,是持续更新文档之间的关系;现在这部分可以由人和 Agent 共同完成。
知识库如何长出成果和产品
这套系统已经不只服务于“记笔记”。它开始向外长出不同形态的成果:
- 课件与教学设计: 从专题地图中提取章节主线,把法条、案例、业务角色和课堂问题组织成 PPT;
- 案例分析: 把分散的裁判观点整理成可以比较、核验和继续补充的案例卡;
- 合规工具: 把研究结论转成风险清单、审查流程、证据留存要求和合规 SOP;
- 持续工作的底稿: 以后再遇到平台治理、直播营销、消费者保护或数据合规问题,可以从已经核验的材料继续判断,而不是重新搜索一遍;
- 新的专业产品: 课程、文章、研究专题和工作方法都可以从同一套知识基础中继续生长。
我很认同 Dan Koe 的项目式学习思路:不要只从“我要学习什么”开始,而要从“我要完成什么项目”开始。没有目标的收藏很容易变成知识坟墓;项目会暴露知识缺口,知识库又为下一个项目提供更好的起点,这才形成真正的知识飞轮。
法律知识库不能把判断完全交给 AI
法律工作最重要的边界,是始终能够回到法源和具体事实。因此,我会要求知识库严格区分:
- 法规、监管文件与裁判文书的原文;
- AI 对材料的归纳与推理;
- 我自己的理解、判断与待核验问题。
找不到完整判决书,就明确标记“未核验”;征求意见稿不能写成现行规则;个案观点不能包装成统一裁判标准;脱离具体业务事实,也不能给出看似确定的结论。
AI 可以承担维护,但最终判断仍然属于人。
我现在更看重的学习能力
AI 时代真正重要的学习能力,不只是会不会提问,而是能不能在提问的同时,把资料、判断和关联沉淀下来,与 AI 共同建成一个会持续生长的知识系统。
对法律人来说,Obsidian 可以逐渐成为自己的第二大脑;对 Agent 来说,它则是一层能够长期读取、维护和继续工作的知识基础。
下一次面对一个新领域,我依然会从同一个动作开始:先别急着要答案,先和 AI 一起把知识库搭起来。